虚拟化技术
从软件翻译到嵌套组合
报告主线与统一框架
每一部分只回答同一组问题:资源与状态由谁控制、关键路径怎样执行、何时需要 hypervisor 介入、介入的代价何在。四个维度(CPU / 内存 / 中断 / 设备)是本文的工程分析框架,不是 Popek–Goldberg 原文的分类——原文的形式模型明确排除了 I/O 与中断。
敏感 ⊆ 特权
RISC-V → IR → x86-64
EL2 / S2 / GICv4 / SMMUv3
把多层语义做对
把跨层往返削掉
为什么并置软件与硬件不是两代产品
二者是实现同一目标的两条路径,且长期共存:QEMU 既能独立提供整机模型,也能把 CPU 执行交给 KVM,自己保留内存后备、设备模型与整机编排。比较的是同一维度上两种机制的取舍,不是替代关系。
为什么分两章嵌套的判据不同
第 3 章问「缺乏架构支持时怎样把多层语义做对」,第 4 章问「已经能嵌套后怎样削减跨层往返」。两问先后相接,性能不可横向排名。
五十年的四个转折从形式判据到跨层优化
演进的分水岭有两条:一条是「谁执行 guest 指令」(翻译 → 原生执行),另一条是「谁承担跨层成本」(陷入转发 → 副本与就地处理)。
三条性质是定义,一个条件是充分条件
-
等价性:程序在 VMM 下与在裸机上不可区分,
但允许两类例外——资源数量不同、时间依赖。 - 资源控制:VMM 对内存与外设握有完全控制;未分配的资源不可触及,已分配的可被收回。
- 效率:统计上占主导的那一子集 guest 指令必须由真实处理器直接执行,VMM 完全不介入。
定理(充分而非必要)
若机器的敏感指令集合 ⊆ 特权指令集合,则可构造出满足上述三性质的 VMM。
陷阱-模拟是这个条件下的一种可行实现,不能外推为所有现代实现的必要条件。
两个边界
机器模型只含处理器模式与 relocation-bounds 内存,显式假设无 I/O 与中断;递归虚拟化定理要求「可虚拟化 + 无时间依赖」,它不承诺固定低开销。
翻译只在缓存未命中时发生
# 运行时主循环:译时与运行时由 TB 缓存衔接
	def cpu_exec_loop(cpu, pc):
	    while True:
	        tb = tb_cache.lookup(pc, cpu.key_state)
	        if tb is None:              # 未命中 → 译时
	            tb = tb_gen_code(pc, cpu)
	            tb_cache.insert(pc, cpu.key_state, tb)
	        pc = tb.run(cpu)             # 命中 → 跑宿主码

	def tb_gen_code(pc, cpu):
	    while True:
	        insn = fetch_decode(pc)
	        if is_control_transfer(insn):
	            ir.append(emit_exit(insn)); break
	        ir.extend(trans_func[insn.opcode](insn))
	    return backend_emit(ir)     # 优化 → 分配 → 发射
- TB(Translation Block):在一组 CPU 状态假设下生成、可独立查找、链接与失效的代码单元。
- 键不只有 PC:特权级、MMU 索引、浮点与向量状态都参与键;状态一变就必须重查。
- TB 不等于严格单基本块:内部可有标号与控制流;helper 调用也不自动封块。
- 块链接:goto_tb 把跳转槽修补成目标 TB 的宿主地址,之后直接跳,不回调度循环。
同一段 guest 代码的三层对照qemu-riscv64 -d in_asm,op,out_asm
IN   428d      addi t0,zero,3
	     4311      addi t1,zero,4
	     006283b3  add     t2,t0,t1
	     c0002f73  rdcycle t5

	OP   add_i64 x5/t0,$0x0,$0x3
	     add_i64 x6/t1,$0x0,$0x4
	     add_i64 x7/t2,x5/t0,x6/t1
	     call csrr,$0x0,$1,x30/t5,env,$0xc00
	     mov_i64 pc,$0x100f4
	     exit_tb $0x0

	OUT  48c7452803000000  movq $0x3,0x28(%rbp)   # env->gpr[5]
	     48c7453004000000  movq $0x4,0x30(%rbp)   # env->gpr[6]
	     48c7453807000000  movq $0x7,0x38(%rbp)   # 常量折叠
	     e8f8a0aa0f        call helper_csrr       # SysV ABI
- guest 寄存器的「家」在 env:0x28(%rbp) 即 gpr[5] 槽位,中间无宿主寄存器参与。
- 常量折叠 ≠ 逐指令替换模板:三条算术剩三条,但末条是算好的 0x7——指令数随块内活跃性涨落。
- helper 调用有两套约束:参数按 SysV 进 esi/rdi;分配器搬参、杀 caller-saved、同步 guest 全局状态。
- rdcycle 退 helper 并封块:CSR 写可能改 mstatus/satp,跨点假设作废——封块由语义决定,helper 本身不是边界。
guest 原生执行,hypervisor 只保留「何时介入」
HCR_EL2.VM 打开 Stage-2;陷阱位决定系统寄存器与指令是否陷入。敏感操作不再由翻译器逐条识别,而由硬件在指令执行处判定。
# vmentry:__guest_enter 的尾部
	  ldp x0, x1, [x29, #CPU_XREG_OFFSET(0)]
	  ...
	  restore_callee_saved_regs x29
	  eret      # 按 SPSR_EL2/ELR_EL2 返回

	# vmexit:VBAR_EL2 → __kvm_hyp_vector
	el1_sync:      # guest 同步异常
	  mrs x0, esr_el2
	  ...          # 仅 HVC 可短路回 guest
	el1_trap:
	  mov x0, #ARM_EXCEPTION_TRAP
	  b   __guest_exit  # 存回 ctxt
	el1_irq: / el1_fiq: / el1_error:
访存被拆成两位管理者各负责的一段
为什么 guest 改页表也越不过边界
最终生效的是两阶段权限的交集:Stage-1 标成可写可执行,Stage-2 仍可限为只读或不可执行。更关键的是 guest 页表自身的访存也走 Stage-2——页表项所在地址是 IPA,读表项本身就要过一次 Stage-2。
代价没有消失,只是换了位置
未命中要 page walk,且 Stage-1 表项读取可能再触发一次 Stage-2 遍历;TLB 命中才接近直接访存。ASID/VMID 让切换不必整表失效,但映射变化仍需软件发起失效。 与 QEMU 每次访存做一次软件 TLB 检查相比,这里把检查交给 MMU。
「退出 guest」≠「回到 QEMU」
Stage-2 缺页由 kvm_handle_guest_abort 沿 memslot 换成宿主虚拟地址后补表;MMIO 先由内核 kvm_io_bus 尝试,无人认领才置 KVM_EXIT_MMIO 交回 QEMU 进程。正常 Stage-1 fault 通常直接进 guest 自己的处理程序。
GICv4:vLPI 的路径与它绕开的软件
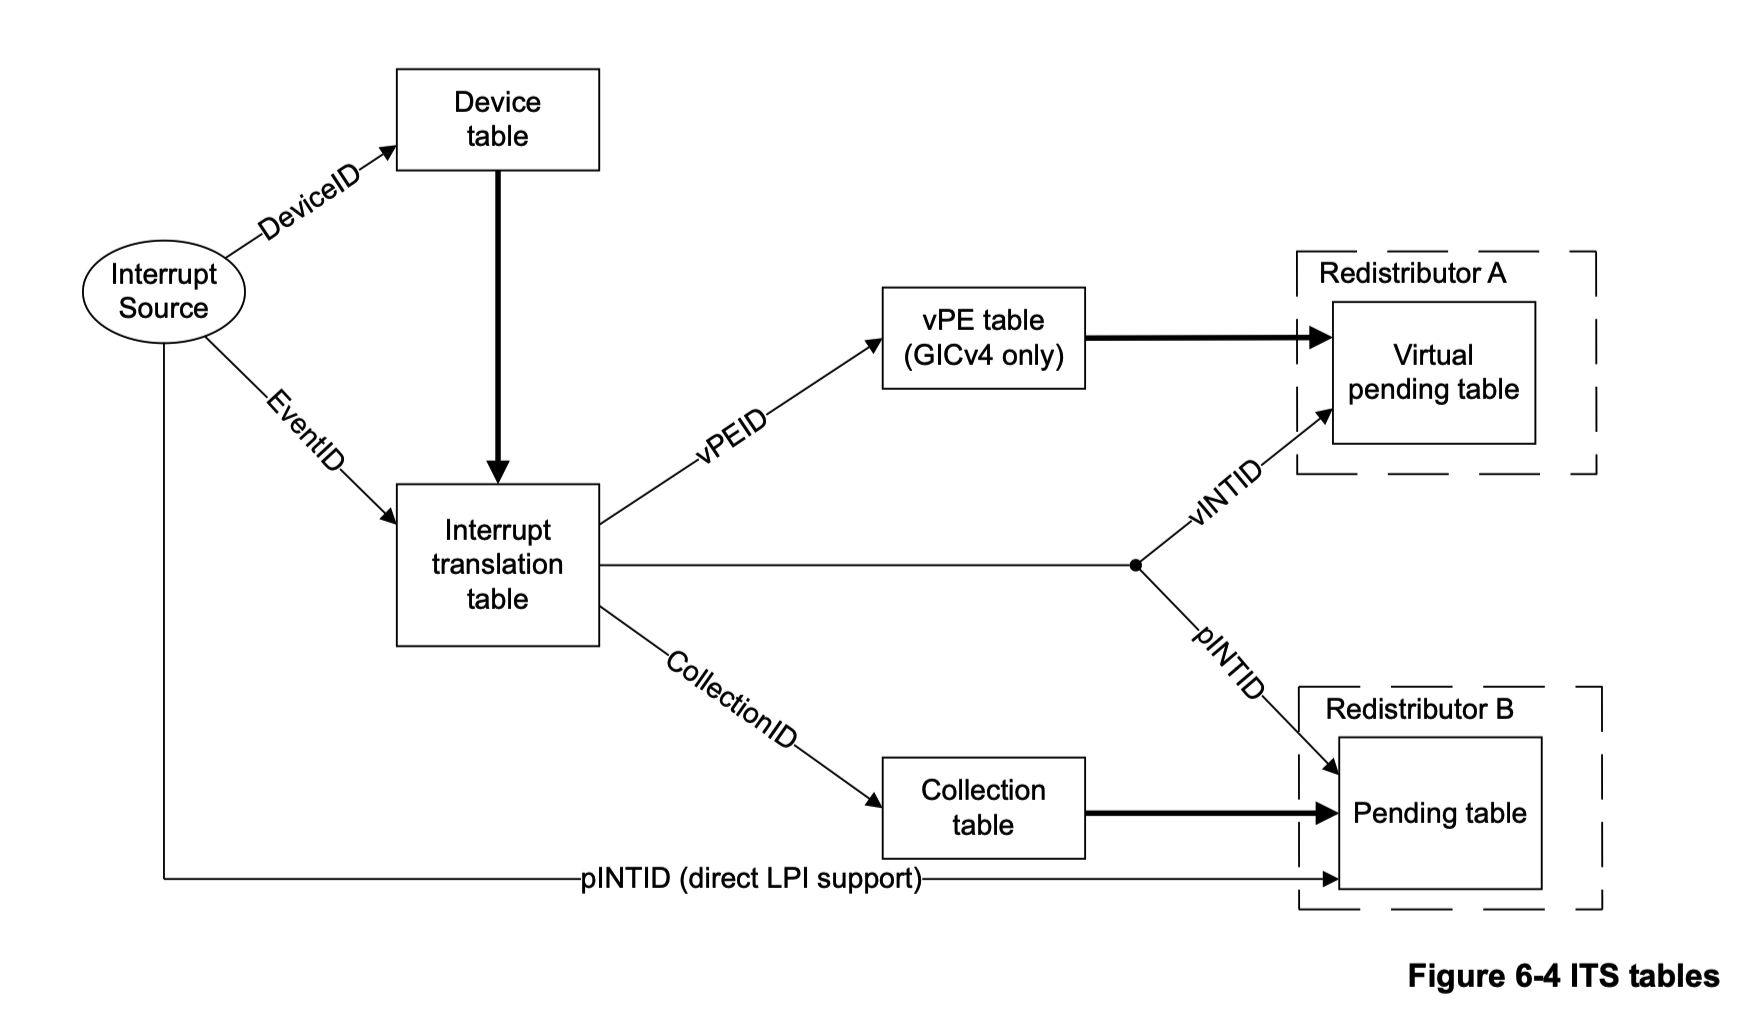
- 这是运行时查表路径,不是配置命令流:表由 ITS 命令队列建立——MAPD 映射设备到 ITT、MAPTI 建 EventID 映射、MAPC 建 Collection、VMAPP/VMAPTI 建 vPE 与虚拟映射。配置在软件、查表在硬件。
- vPE 有两处硬件落点:vPE table 表项(ITS 侧,回答 pending 表在哪、目标 Redistributor 是谁,由 VMAPP 建立)与 Redistributor 持有的两页(RD 侧,回答往哪置位,驻留时写 VPENDBASER / VPROPBASER)。
- 驻地决定走哪条:vPE 驻留 → 硬件直接置 pending 并注入,全程无 EL2 退出;未驻留 → 按映射里的 doorbell 产生物理中断,由 KVM 唤醒 vCPU 后重新驻留再兑现。
一条 vLPI 到 guest 手里,硬件只做四件事
与 List register 一起仲裁
assert 虚拟 IRQ/FIQ
进 IRQ 入口
pending → active → inactive
省掉的是软件动作
KVM 不写 List register、不模拟 IAR/EOI,也没有一次 EL2 退出:查表、置位、仲裁、呈现全在硬件与 guest 之间完成。guest 感知不到 hypervisor,中断处理代码一行不改(ICC_* 在 IMO/FMO 置位时落到 ICV_*)。
直注不是绕过优先级体系
注入的 vLPI 与 List register 里已有的虚拟中断一起仲裁——规范原文写明两者 "prioritized together"。所以 GICv4 加的是「vLPI 能直达」,不是「中断不再排序」。
边界
只覆盖已驻留 vPE 的 vLPI 这一条热路径。映射配置、vCPU 调度、驻留切换、未驻留时的 doorbell 唤醒,全部仍由软件完成——不能说成「所有中断都绕过 hypervisor」。
SMMUv3:DMA 这条绕开 CPU 的路径也要过边界
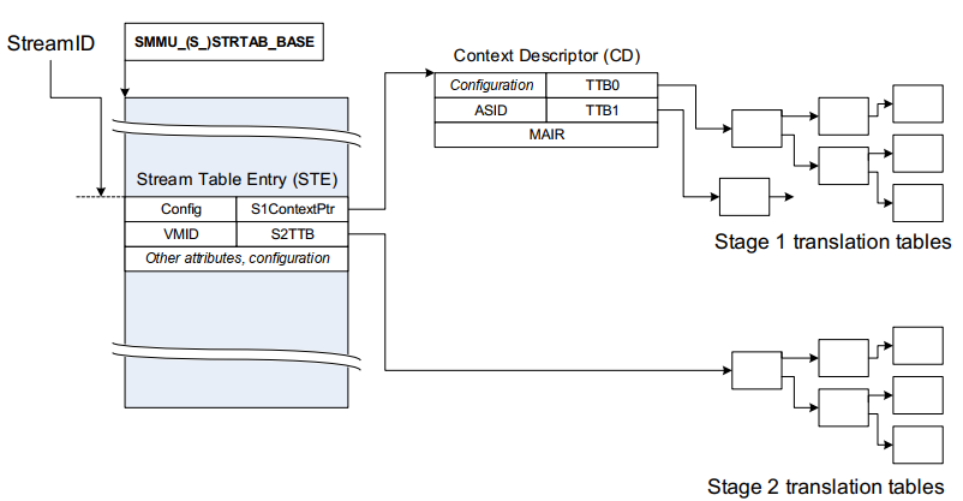
# 建映射(软件):VFIO 把 guest 内存锁进设备 DMA 域
	def arm_smmu_attach_and_map(master, dom, iova, pa, prot):
	    ste = stream_table[master.streamid]
	    ste.config = S2_TRANS          # 只做 stage-2
	    ste.s2vmid = dom.s2_cfg.vmid   # 所属 VM
	    ste.s2ttb  = dom.pgtbl_ops.vttbr
	    dom.pgtbl_ops.map_pages(iova, pa, prot)

	# 运行时(硬件):设备 DMA 查表,软件不参与
	def smmu_translate_dma(streamid, addr):
	    ste = stream_table[streamid]
	    pa  = walk(ste.s2ttb, addr)   # IPA -> PA
	    check_permission(ste, pa)     # 越界则 fault
具体一例:直通网卡 StreamID=0x10、s2vmid=7,建 IPA 0x4000_0000 → PA 0x1_2000_0000;driver 在描述符里填 0x4000_1000,SMMU 走出 0x1_2000_1000。若改成域外地址,得到的是 translation fault,而不是放行。
口径:stage-2 only 是架构许可的一条路径;Linux 普通直通域在硬件支持时会优先选宿主管理的 S1,因此「物理 SMMU 用了 S1」不能推出「guest 有 vIOMMU」。SMMU 也不模拟设备。
硬件给机制,软件给管理与组合
| 维度 | QEMU 软件(只展开 CPU 维) | Arm + KVM 硬件辅助 | 仍是软件的责任 |
|---|---|---|---|
| CPU | TCG 翻译为宿主代码,TB 缓存复用,敏感操作退 helper | EL1/EL0 原生执行,EL2 用 HCR_EL2 选择性陷入 | 陷入配置、vCPU 上下文与调度 |
| 内存 | 软件 MMU 与软件 TLB 解释 guest 页表 | Stage-1 + Stage-2,MMU 做缓存与遍历 | memslot 换算、S2 补表、TLB 失效 |
| 中断 | 控制器模型维护 pending,经架构异常投递 | GICv3 虚拟 CPU 接口;GICv4 直注 vLPI | 映射配置、驻留切换、doorbell 唤醒 |
| 设备 | MemoryRegion 回调响应 MMIO,后端完成请求 | SMMU 约束真实 DMA;模拟 / virtio / 直通并存 | 设备模型、复位、可迁移性、路由 |
难点不在「多一层特权环」,而在资源归属不对称
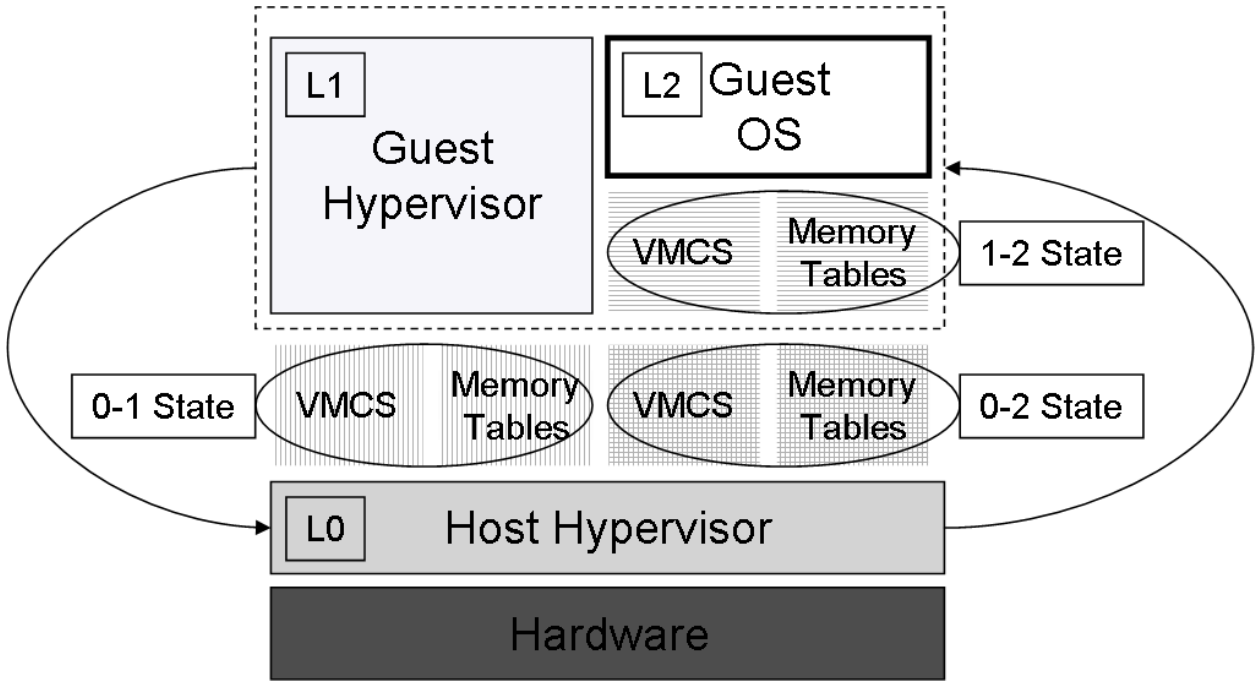
- 不是所有事件都走完这条链:外部中断、NMI,以及只在 VMCS02 里 trap 的事件属于 L0 自己,就地处理后直接恢复 L2——从 L1 视角这些事件根本不存在。
- 「L0 保留最终控制」的准确含义是归属判定权在 L0,而不是层层转发。这条判定会贯穿四维:退出归谁处理、缺项归谁填、设备地址归谁分配。
- 合成的统一形状:L1 的要求(VMCS12 / EPT12 / L1 侧 IOMMU 映射)+ L0 的约束(VMCS01 / EPT01 / 真实 IOMMU)→ 一份硬件当下可执行的产物。
三份 VMCS 的分工与四条合成规则
- host state 整组替换:VMCS02.host 必须是 L0 自己的(HOST_RIP 指 vmx_vmexit),因为从 L2 退出要回 L0,不是回 L1。
- VMCS12.host 抄进 VMCS01.guest:硬件只有 guest/host 两个槽位,没有第三个承载「下层 hypervisor 的 host 状态」,只能借 guest 槽位。
- guest state 大多直抄,例外是 CR0/CR4:有 guest/host mask 机制,装进 VMCS02 的是有效值再补写 CR0_READ_SHADOW。
- control data 按位或、且严格单调:VMCS02 的 trap 集合 ⊇ VMCS01 ∪ VMCS12。多出来的正是「L1 想要而 L0 不想要」的事件。
# L0 处理 L1 的 VMX 指令:两条路
	# ① 改状态:L1 --exit--> L0 --entry--> L1
	def handle_vmwrite(vcpu, field, val):
	    vmcs12.field = val
	    nested_vmx_succeed(vcpu)   # 清 CF/ZF
	    # 改三处:结果寄存器 / RFLAGS / GUEST_RIP

	# ② 换环境:L1 --exit--> L0 --entry--> L2
	def handle_vmlaunch(vcpu):
	    prepare_vmcs02(vcpu, vmcs12)  # 合成
	    vmx_vcpu_run(vcpu)            # 不返回 L1
术语边界:Turtles 所说的「VMCS shadowing」是 L0 在软件里影子维护 VMCS12,与 Intel Haswell 之后的同名硬件特性不是一回事。
三层地址,压进硬件能走的两层
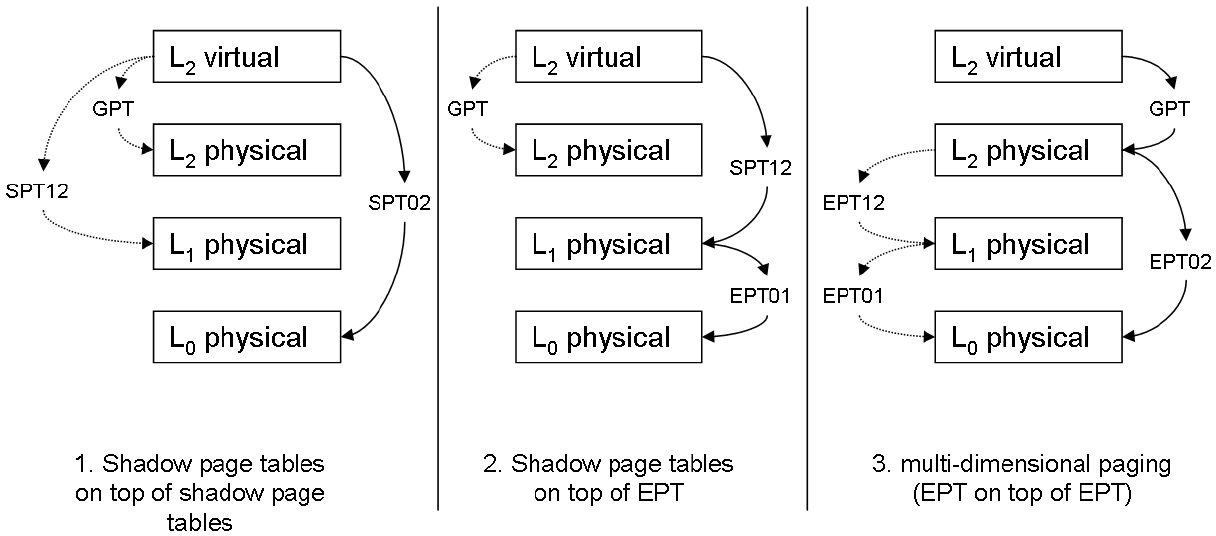
前两栏的共同点:L1 用影子页表跑 L2,于是 L2 的每次页故障与页表写都要 L1 处理并经 L0 转发。本节只展开第 ③ 栏。
- 能力虚拟化:L0 把 EPT 能力暴露给 L1,L1 相信自己能建 EPT,于是建出 EPT12——但硬件只有一张 EPT。
- 折叠:L0 把 EPT12 与自己的 EPT01 折叠成 EPT02,记的是两次翻译的终点;硬件对 L2 GPA 只遍历一次。
- 缺项分流:EPT12 有映射 → 拼 EPT01 写入 EPT02;没有 → 说明该页尚未由 L1 分配,转给 L1。
- 三种组合而不是四种:L0 能「多给」(假装有 EPT),但不能「凭空造」——CPU 没有 EPT 硬件就模拟不出 EPT 行为。
正确性之后剩下的成本:退出被逐级放大
根因:L1 每处理一次 L2 退出,都要执行多条 vmread/vmwrite,而每条又各自触发一次对 L0 的退出。约 1000 周期是单层的模式切换成本。
| 宏观负载 | 相对单层 | DRW 配置 |
|---|---|---|
| kernbench 运行时间 | +14.5% | +10.3% |
| SPECjbb 分数 | −7.8% | −6.3% |
KVM 同时充当 L0 与 L1、启用多维分页。DRW 是修改 L1 使其直读直写 VMCS12 的评测配置——它改动了 guest hypervisor,不能与未修改 guest 的数字合并成一个「6–8% 上界」。
决定是否退出的,不是「敏感」这个标签
而是这条指令的效果落在哪里:单层 VMX 下 L1 执行 vmread/vmwrite 必然退出,根因是处理器手上没有一份能替 L1 接收这次访问的控制结构。一旦硬件能提供副本,同一条指令就能原地执行。
x86VMCS shadowing(Haswell)
L0 在真实 VMCS01 的 link pointer 里填入另一块 shadow VMCS,并准备两张各 4 KB 的 VMREAD/VMWRITE 位图,每个字段编码一位:位为 0 的字段不退出,直接读写副本。
筛选粒度:可写字段 24 项、只读字段 12 项(vmcs_shadow_fields.h)。影子里的改动由 copy_shadow_to_vmcs12() 在 L1 进 L2、vmclear/vmxoff、导出状态三个时机拷回。
ArmFEAT_NV / NV2
NV(v8.3)把 EL1 访问「只在 EL2 定义的寄存器」从 UNDEFINED 改成陷入 EL2;NV2(v8.4)再进一步:HCR_EL2.NV=1 且 NV2=1 时,硬件把访问改写成对 VNCR_EL2 所指页面的 load/store。
「读一个 EL2 寄存器」从一次异常变成一次普通访存;页面仍在 L0 手里,建立、失效与同步由软件负责。
结论与边界
两者不宜推成同构——一边让字段访问落到影子控制结构,一边把寄存器访问改写成内存访问,指令、状态与失效规则都不同。
能说的是同一件事:只要架构能提供一份 L0 仍能约束的副本,退出就能从关键路径上挪走。代价没消失,只是转成了副本一致性维护——VMEntry/VMExit、TLB 失效与中断投递仍要回 L0。
先分清两张表各缺什么
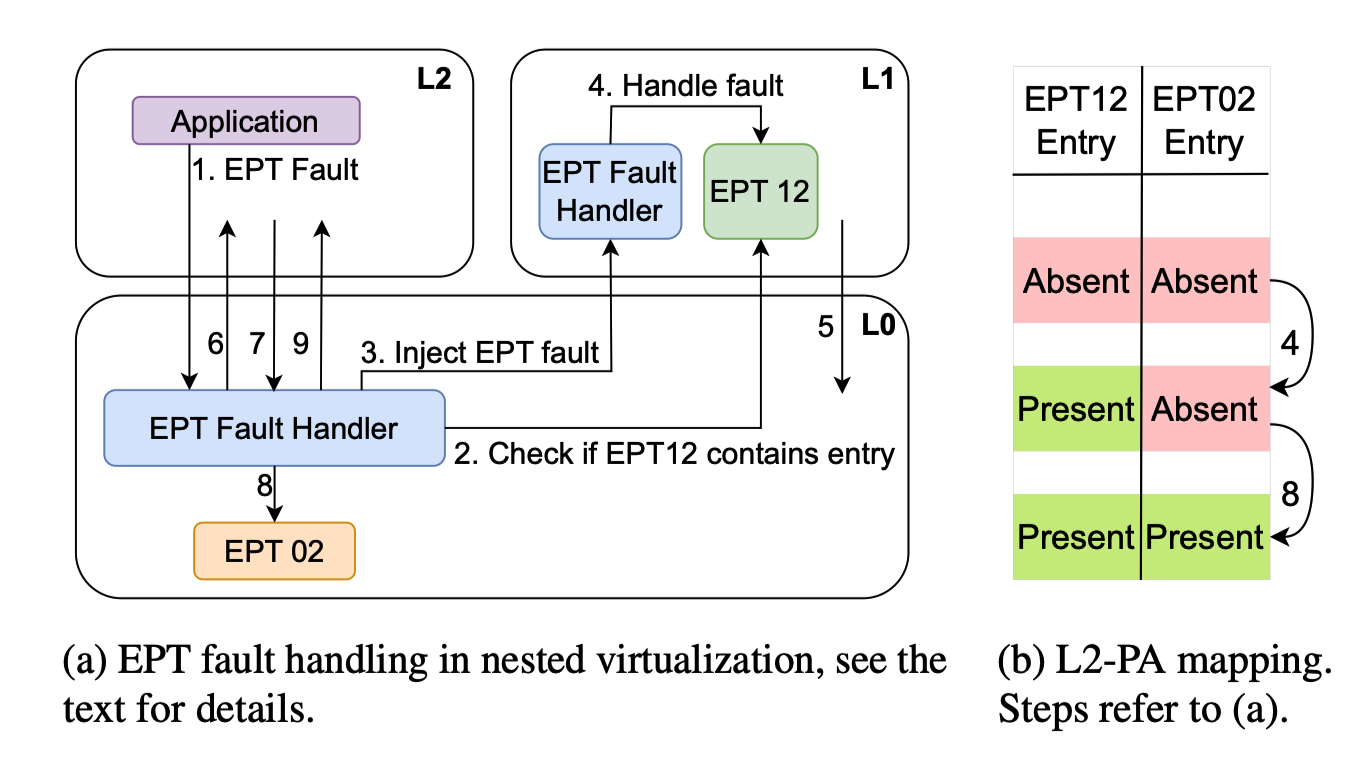
# P = L2-PA,M = L1 帧,H = 机器地址
	EPT12: P->M   EPT01: M->H   EPT02: P->H

	def handle_l2_ept_fault(P, access):
	    if ept12_lookup(P).present:
	        install_ept02_from_ept12(P)  # 自补
	        resume_l2(); return
	    # EPT12 也缺 → 传统路径进 L1
	    if hyperupcall_ept_fault(P) == OK:
	        install_ept02_from_ept12(P)
	        resume_l2()               # 不进 L1
	    else:
	        inject_ept_fault_to_l1(P)
	        resume_l1()          # 慢路径
注册路径与热路径要分开看
安装(一次性)
L1 经 hypercall 把编译后的 eBPF 交给 L0,经 KVM 与用户态组件验证、加载,再 link 到 EPT fault hook。load 与 link 拆成两个 hypercall,同一套 map 实例可挂多个 hook。
共享状态(四类 + 一把锁)
预分配帧池(4096 帧)、QEMU 页表根 cr3、hyperupcall fault log、L1 侧 page fault log,加一把双方都能取的锁。map 经共享内存 PCI 设备映射到 L1。
能力受限
bpf_probe_read_hyperupcall 只读有效、已映射且属于发起它的 L1 的物理内存:verifier 管程序形态,helper 管地址授权。
def hyperupcall_ept_fault(P, access):
	    if not try_lock(shared): return FALLBACK
	    if fault_log.is_full():   return FALLBACK
	    V = qemu_va_for(P)          # memslot 关系换算
	    M = walk_qemu_page_table(shared_cr3, V)
	    if M is not None:        # 复用已有帧
	        ept12_install(P, M, access)
	        fault_log.append(P); return SUCCESS
	    if page_fault_log.contains(P):
	        return FALLBACK       # L1 正并发处理
	    M = frame_pool.pop()
	    if M is None: return FALLBACK
	    ept12_install(P, M, access)
	    fault_log.append(P); return SUCCESS
一致性靠延迟补偿:L1 下次因其他 VM-exit 进入时消费 fault log 补自己的页表;shmem 缺页路径则包一层,先查 EPT12 是否已被填好。锁、双日志、帧池与原有 L1 路径共同兜住回退。
收益只发生在缺页热路径上
(相对普通嵌套 L2)
仍比非嵌套参考差约 8%
(4 KiB 页配置)
大页削弱了收益
读数时要注意口径
启动测的是「发出命令 → 容器内 Web 服务能响应请求」,不是 guest 内核 boot;平均延迟接近非嵌套参考,99p 仍有差距。1 GiB 内存按需映射,收益依赖缺页在负载中的占比、页大小与后备内存组织——不能由启动结果外推到稳定运行阶段。
实验平台是结论的一部分
双路 Xeon Silver 4216,vCPU 与 vhost 线程固定在同一 NUMA 节点内不同物理核,关闭 SMT,并设 idle=poll 与 nopti。这些条件影响空闲等待与隔离成本,因此本文只把数值视为论文报告,不当作生产环境的预先保证。
与 Turtles 不在同一坐标系
Turtles 报告的是相对单层的减速(14.5% / 7.8%),HyperTurtle 报告的是相对普通嵌套的加速(5.25×)。两列数字不能拼成一条趋势线。
该被追问的三处
原型覆盖范围仍然很窄
- EPT hyperupcall 不支持分配大页;尚未进入 QEMU 页表的部分 page-cache 页不能直接处理。
- EPT hook 是全局的,原型只支持一个 L1 中的一个 L2 使用;复杂 L1 功能的并发同步限制了完整下放。
- 原有 L1 路径必须长期保留——它是回退路径,不是遗留代码。
评价只报理想路径还不够
- 应报告回退率、尾延迟与宿主 CPU 时间,检验省下的切换是否被一致性维护重新消耗。
- 帧池补充频率、日志占用率、锁竞争都需要给出,否则「快」只是快路径的成功率。
- 安全边界要与性能分开评价:verifier 约束执行形态,helper 的地址授权与 VM 归属才决定它能碰什么。
判断信任模型的张力
- 该机制假定 L0 能读取并处理 L1 的状态,不能直接套用到把 L0 排除出信任边界的机密虚拟机模型。
- 若只允许厂商预审签名的程序,L1 就从「定逻辑」退化为「从菜单里挑」——Goal 2(保留 L1 策略控制)被上收。
- 后续工作更可能在一致性协议的成本上,而不是继续压低理想路径延迟。
以上三条中,前两条来自论文自述的局限与实验边界;第三条的「信任模型张力」是报告人的判断,不是原文结论。
三点判断
- 四维必须协作:它们是同一台机器的执行、地址、异步事件与数据通路,状态彼此约束——地址转换决定访存与 DMA 是否落到正确内存,中断投递依赖 CPU 上下文与设备后端,完成通知又回到中断。割裂看任何一维,都看不到整机为何能跑。
- 硬件减少的是高频路径上的软件介入,策略与语义仍在软件:Stage-2 把翻译下放,但内存后备与映射维护仍是 KVM 的工作;GICv4 只对驻留 vPE 直接注入;SMMU 约束 DMA,却不实现网卡或磁盘。
- 嵌套的本质是把资源边界与上层策略组合起来,而这一步分成两个问题:Turtles 先把嵌套做对(代价是跨层往返与逐级放大),HyperTurtle 再削减它的成本(适用范围是被安全下放且一致性成本可控的热路径)。先把嵌套做对,再谈削减成本。
主要文献与出处正式报告共引 11 项,此处列主要 8 项
- [1]Popek & Goldberg. Formal Requirements for Virtualizable Third Generation Architectures. CACM 17(7): 412–421, 1974.
- [2]Bellard. QEMU, a Fast and Portable Dynamic Translator. USENIX ATC (FREENIX), 2005: 41–46.
- [3]Ben-Yehuda 等. The Turtles Project: Design and Implementation of Nested Virtualization. OSDI '10, 2010.
- [4]Ben Zur 等. Accelerating Nested Virtualization with HyperTurtle. USENIX ATC '25, 2025: 987–1002.
- [5]Dall & Nieh. KVM/ARM: The Design and Implementation of the Linux ARM Hypervisor. ASPLOS '14, 2014: 333–348.
- [6]Arm Ltd. Armv8-A Architecture Reference Manual, DDI 0487F.b, 2020.
- [7]Arm Ltd. GIC Architecture Specification(IHI 0069D); SMMU Architecture Specification(IHI 0070B)。
- [8]QEMU(commit 56afd82b…)与 Linux 7.0.14 源码:accel/tcg、 arch/arm64/kvm、arch/x86/kvm/vmx、drivers/iommu。
图中原始图元引自 OSDI '10 Fig. 3/4、ATC '25 Fig. 1/4、IHI 0069D Fig. 6-4 与 IHI 0070E.a。本文未做性能复现。